Python 中 list 的传值问题

我在做一个小程序,需要生成一个随机数列表,然后将之赋值给2个 list,并需要这两个列表完全独立(即列表值指向不同的内存地址)。最开始是这样的:

>>> a = [5,4,3,2,1]
>>> b = a
>>> print(a,'-',id(a)) # id是 python 查看对象地址的方法
[5, 4, 3, 2, 1] - 4516275720
>>> print(b,'-',id(b))
[5, 4, 3, 2, 1] - 4516275720 # 显然,此时a和b指向同一个地址
>>> b.sort() # sort()是 python 的内置排序函数
>>> print(b,'-',id(b))
[1, 2, 3, 4, 5] - 4516275720
>>> print(a,'-',id(a))
[1, 2, 3, 4, 5] - 4516275720 # 我去,怎么回事???a 怎么也变了?

Python 的变量赋值机制并不是真的给变量赋值(实际上从头到尾都不存在 list 的容器),只是把变量名当做一个标签,贴在内存地址上,当值发生变化的时候,并不是改变值本身,而是将内存地址对应的标签『唰』的一下撕下来,然后贴到另一个地址上——此所谓『铁打的内存,流水的变量名』。
对于复制 list,按照官方文档的说法,应该这样操作:

b = a[:]
# https://docs.python.org/3/faq/programming.html#how-do-i-copy-an-object-in-python

此时是这样的:

>>> a = [5,4,3,2,1]
>>> b = a[:]
>>> print(a,'-',id(a))
[5, 4, 3, 2, 1] - 4516276488
>>> print(b,'-',id(b))
[5, 4, 3, 2, 1] - 4516276232

可见在 b = a[:] 这一过程中,Python 在内存中创建了一个新值,并将 b 的标签贴到了上面,迥异于我们最开始的过程。
其实上述过程并非发生在所有数据类型中。

>>> A = 5
>>> B = A
>>> id(A)
4540535120
>>> id(B)
4540535120
>>> B = 3
>>> A
5
>>> id(A)
4540535120
>>> id(B)
4540535056

关于这个问题,我还没有研究明白,还没搞懂到底哪些变量是这样传值的,算是一个小小的坑吧。
参考资料:

  1. http://stackoverflow.com/questions/8744113/python-list-by-value-not-by-reference
  2. https://docs.python.org/3/faq/programming.html#how-do-i-copy-an-object-in-python
Tagged : /

几种排序算法的比较

整个十一假期就在折腾这几个算法,这篇总结性文章就是简要的介绍了几个基础算法的特性,并附带了 Python 的实现。
不同算法适合不同情况的数组,但在不知道输入规律的时候,使用时间复杂度低算法的比较保险。
Big O:上界
Big Ω:下界
Big Θ:确界

Big O 比较

big_o_complexity
O(n²):冒泡排序(稳定)/选择排序(不稳定)/插入排序(稳定)
O(nlgn)~O(n²):希尔排序(不稳定)
O(nlgn):堆排序(不稳定)/归并排序(稳定)/快速排序(不稳定)

Bubble Sort 冒泡排序

def bubble_sort(arry):
    n = len(arry)                   #获得数组的长度
    for i in range(n):
        for j in range(1,n-i):
            if  arry[j-1] > arry[j] :       #如果前者比后者大
                arry[j-1],arry[j] = arry[j],arry[j-1]      #则交换两者
    return arry

时间复杂度、稳定性

平均情况:O(n²)
最坏情况:O(n²)
最好情况:O(n)
稳定
辅助空间O(1)

特点

最优情况为全部正序时经过 n-1 次比较即可完成排序,最差情况是倒序。因此冒泡算法对数组的有序性很敏感,适合对规模较小、且比较有序的数据进行排序。[1]

优化方案

  1. 如果某一次遍历没有发生数据交换,则代表已完成排序,可停止迭代。
  2. 记录遍历时最后一次数据交换的位置,后面的数据已经有序,因此可以缩小下次循环的范围。

Selection Sort 选择排序

def select_sort(ary):
    n = len(ary)
    for i in range(0,n):
        min = i                             #最小元素下标标记
        for j in range(i+1,n):
            if ary[j] < ary[min] :
                min = j                     #找到最小值的下标
        ary[min],ary[i] = ary[i],ary[min]   #交换两者
    return ary

时间复杂度、稳定性

平均情况:O(n²)
最坏情况:O(n²)
最好情况:O(n²)
不稳定
辅助空间O(1)

特点

运行时间与输入状态无关(随机排列与正序排列消耗相同的时间)。同时移动次数最少(与数组大小呈线性关系)。[1]

Insertion Sort 插入排序

def insert_sort(ary):
    n = len(ary)
    for i in range(1,n):
        if ary[i] < ary[i-1]:
            temp = ary[i]
            index = i           #待插入的下标
            for j in range(i-1,-1,-1):  #从i-1 循环到 0 (包括0)
                if ary[j] > temp :
                    ary[j+1] = ary[j]
                    index = j   #记录待插入下标
                else :
                    break
            ary[index] = temp
    return ary

时间复杂度、稳定性

平均情况:O(n²)
最坏情况:O(n²)
最好情况:O(n)
稳定
辅助空间:O(1)

特点

输入状态会影响运行效率,对有序数组排序要比对随机排列、逆序排列的数组快,因此适用于部分有序的非随机数组。当『数组中每个元素距离它的最终位置都不愿』『一个有序的大数组接一个小数组』『数组中只有几个元素的位置不正确』时,插入算法的速度很可能比其他算法都快。[2]

Shell Sort 希尔排序

def shell_sort(ary):
    n = len(ary)
    gap = round(n/2)       #初始步长 , 用round四舍五入取整
    while gap > 0 :
        for i in range(gap,n):        #每一列进行插入排序 , 从gap 到 n-1
            temp = ary[i]
            j = i
            while ( j >= gap and ary[j-gap] > temp ):    #插入排序
                ary[j] = ary[j-gap]
                j = j - gap
            ary[j] = temp
        gap = round(gap/2)                     #重新设置步长
    return ary

时间复杂度、稳定性

平均情况:O(nlgn)~O(n²)
最坏情况:O(n²)
最好情况:O(n1.3)
不稳定
辅助空间:O(1)

特点

希尔排序将数组分成较短的子数组、并使之部分有序,很适合插入排序。希尔排序对中等大小数组的排序时间可以接受,代码量小,且不需要额外内存空间。当没有系统排序函数可用时,可以考虑先用希尔排序,再考虑是否值得替换为更复杂的排序算法。[3]

Merge Sort 归并排序

def merge_sort(ary):
    if len(ary) <= 1 : return ary
    num = int(len(ary)/2)       #二分分解
    left = merge_sort(ary[:num])
    right = merge_sort(ary[num:])
    return merge(left,right)    #合并数组
def merge(left,right):
    '''合并操作,
    将两个有序数组left[]和right[]合并成一个大的有序数组'''
    l,r = 0,0           #left与right数组的下标指针
    result = []
    while l<len(left) and r<len(right) :
        if left[l] < right[r]:
            result.append(left[l])
            l += 1
        else:
            result.append(right[r])
            r += 1
    result += left[l:]
    result += right[r:]
    return result

时间复杂度、稳定性

平均情况:O(nlgn)
最坏情况:O(nlgn)
最好情况:O(nlgn)
稳定
辅助空间:O(n)

特点

归并排序在最坏的情况下复杂度为O(nlgn),和其他基于比较的排序算法所需的最小比较次数相同。

Quick Sort 快速排序

用递归在 Python 中实现快速排序会遇到 RuntimeError: maximum recursion depth exceeded 的错误提示,原因是 Python 的递归深度默认为1000(可以用 sys.getrecursionlimit() 来查看),有两种方式解决为题。一种是用循环重写算法,另一种比较简单粗暴,直接用 sys.setrecursionlimit(99999) 把递归深度设置为 99999 这种大数字,更详细可参见这里

def quick_sort(ary):
    return qsort(ary,0,len(ary)-1)
def qsort(ary,left,right):
    #快排函数,ary为待排序数组,left为待排序的左边界,right为右边界
    if left >= right : return ary
    key = ary[left]     #取最左边的为基准数
    lp = left           #左指针
    rp = right          #右指针
    while lp < rp :
        while ary[rp] >= key and lp < rp :
            rp -= 1
        while ary[lp] <= key and lp < rp :
            lp += 1
        ary[lp],ary[rp] = ary[rp],ary[lp]
    ary[left],ary[lp] = ary[lp],ary[left]
    qsort(ary,left,lp-1)
    qsort(ary,rp+1,right)
    return ary

时间复杂度、稳定性

平均情况:O(nlgn)
最坏情况:O(n²)
最好情况:O(nlgn)
不稳定
辅助空间:O(nlgn)~O(n)

特点

在实际应用中,一般比其他算法快很多,内循环很小,原地排序(仅需要很小的辅助栈),且将长度为 N 的数组排序的时间与 NlgN 成正比。但很脆弱,实际性能会因某些错误变成平方级。[4]
快速排序和归并排序使用分治法和递归进行排序,但快排在合并子数组后是自然有序的大数组;归并在合并阶段则繁琐一些,还要再次进行比较。
在对数组进行切分不平衡时,会导致性能低效(例如第一次从最小元素切分、第二次从第二小的元素切分……)。解决该问题,可以对数组进行随机排序,避免性能下降到极低。

优化

  1. 快排在小数组中比插入排序慢,因此在排序小数组时使用插入排序。
  2. 三取样切分。
  3. 熵最优排序[5]

以上三种优化是《Algorithms 4th》中对于快排性能的优化,都是对算法本身做了一些改进。而最著名的优化则是《算法导论》中提到的『随机化快速排序』,与上述三种性能优化有很大不同。
随机化快速排序,一般来说都是将取主元的过程随机化。随机化快速排序的『优化』,并没有提高快排的性能,而是避免了某些序列使快排性能大幅降低到O(n²)的可能性、防止他人设计一个序列对服务器发起DoS攻击,使排序更加稳定和安全(我发现还有很多人有类似的误解)。事实上随机化快速排序和普通快速排序在时间复杂度上同为O(nlgn),实际实验中也没有显著差异。

知乎上一个用户对快排和随机快排的性能做了测试,但我猜他可能也理解错了,他所做的只是在优化随机快排的代码,但并没有显著提高算法性能或降低复杂度(知乎链接)。Thomas Cormen 在 Quora 中也回答了关于随机化快排和普通快排性能差异的问题(Quora链接),但是他本人在《算法导论》(中文版100页,英文版179页)中并没有把这个问题讲的很透彻,也许算是一个微小的失误。

Heap Sort 堆排序

def heap_sort(ary) :
    n = len(ary)
    first = int(n/2-1)       #最后一个非叶子节点
    for start in range(first,-1,-1) :     #构造大根堆
        max_heapify(ary,start,n-1)
    for end in range(n-1,0,-1):           #堆排,将大根堆转换成有序数组
        ary[end],ary[0] = ary[0],ary[end]
        max_heapify(ary,0,end-1)
    return ary
#最大堆调整:将堆的末端子节点作调整,使得子节点永远小于父节点
#start为当前需要调整最大堆的位置,end为调整边界
def max_heapify(ary,start,end):
    root = start
    while True :
        child = root*2 +1               #调整节点的子节点
        if child > end : break
        if child+1 <= end and ary[child] < ary[child+1] :
            child = child+1             #取较大的子节点
        if ary[root] < ary[child] :     #较大的子节点成为父节点
            ary[root],ary[child] = ary[child],ary[root]     #交换
            root = child
        else :
            break

时间复杂度、稳定性

平均情况:O(nlgn)
最坏情况:O(nlgn)
最好情况:O(nlgn)
不稳定
辅助空间:O(1)
2. 特点
目前唯一的能最优利用时间与空间的算法,最坏情况下也能保证 2NlgN 次比较和恒定的辅助空间。当空间紧张时(例如嵌入式),堆排序用几行代码就能实现实现较好性能。
缺点是无法利用缓存,缓存未命中的次数远高于大多数在相邻元素间比较的算法。
sort

通过倍率实验预测程序的增长数量级

可以使用倍率实验来预测任意程序的增长数量级:
每次实验时使输入翻倍,计算时间,并求两次运行时间的比值。反复运行直到比值趋近于2的b次方。[6]

算法的『稳定性』是什么

稳定性指,当排序的元素中有相同的值时,这些具有相同值的元素在排序后的前后位置是否发生变化的性质。如果变化,则不稳定;如果不变化,则稳定。在 Bubble Sort 中,相邻元素互相交换,如果两个相邻元素相等则不需交换;如果两个相等的元素彼此之间有间隔,那么即便它们和相邻元素交换后,其相对的前后位置也不会发生变化,所以是稳定的。而在 Selection Sort 中,第一个元素与最小的元素交换、第二个元素与第二小元素交换等等,间隔有可能很大从而在交换时跳过了相同值的元素,进而造成相同值元素前后位置改变,因此是不稳定的。
排序的键值有可能只是元素的一个属性,如果元素本身还具有其他属性,那么键值相同的元素排序后的相对顺序还与其他属性有关。例如用稳定的算法对员工按工资排序,假如原数组是按年龄排序的,那么月薪同为7000元的3个人在按工资排序后仍然可以保持年龄正序,即最初的相对位置不变。

参考资料:

[1]《Algorithms 4th》 P248
[2]《Algorithms 4th》 P252
[3]《Algorithms 4th》 P262
[4]《Algorithms 4th》 P288
[5]《Algorithms 4th》 P296
[6]《Algorithms 4th》 P121

Tagged : / / / /

万用骰子脚本(跑团专用)

几个月前,我写过一个专门用来玩卡坦岛的命令行骰子工具,里面的骰子函数都是写死的,只能选2d6/2d10/3d4这几个,够用,但是不方便,适用性太差。最近入了《Pathfinder基础包》,准备重新开始跑团,看几个跑团QQ群里都有骰子机器人(方便大家开网团的时候投骰子),他们输入『.r 3d6』『.r 4d10』甚至『.r 1d97』这种实际中并不存在的骰子都可以得到值,自由度非常高。
于是我计划用Python来实现这种高自由度的骰子。首先遇到的问题就是如何让程序识别『3d6』『1d4』『1d8』这种跑团黑话。先普及一下,d4/d6/d8/d10/d20等都指骰子的面数,例如d4指的是四面骰,d20则指二十面骰,1d4指扔1个四面骰,2d6则指扔两个六面骰。普通游戏一般用不到这么多种类的骰子,而在以大量数值检定为核心的TRPG(桌面角色扮演游戏)中,这些骰子就不可或缺了。
首先想到的方法是用正则表达式来解析命令。以最常用的『1d6』为例,『1』指骰子个数,『6』是骰子类型(面数),『d』则是分割二者的分隔符。用正则表达式来写的话,应该是这样:

roll = input('> ')
match = re.search(r'(\d+)([Dd])(\d+)', roll)

先让用户输入命令,然后开始解析命令。命令的结构是『数字』+『D或d』+『数字』,正则表达式如上图。最早的版本里,是 r'(\d)([Dd])(\d)’ ,两个数字位都没『+』,后来发现第二个数字位必须带『+』(因为骰子类型有可能是两位数甚至三位数,例如1d20,1d100),于是我干脆把两个数字位都变成可以无限位取值的。
到此,解析命令完成。下一个问题发生在定义函数时的全局变量上。早期版本如下:

result = 0
def d(n):
    result = randint(1, n)

函数外部出现了变量 result,函数内部又给 result 赋值,电脑就懵圈了。在这里,我一直没搞懂的问题是,定义函数时的返回值,并不是返回给某个变量,而是对应了这个函数本身。result = 0 这个变量的初始化也可以删掉。在朱老师的指导下,终于搞明白这个问题,于是代码顺利改成这样:

def d(n):
    return randint(1, n)

最后,做好一个 for 循环来实现反复扔骰子的动作即可:

for i in range(m):
    result = d(n)
    dice.append(result)
    print(result)
print('和为: ', sum(dice))

至此,其实还没有写完,脚本还有很多地方需要完善,但是已经不再是当初那个被朱老师批评的『到处给全局变量赋值的超级烂代码』了。日拱一卒,余欣慰也。
Github地址
欢迎各位去围观我写的其他小脚本,帮我改改这些超级烂代码!

Tagged : / /

时刻准备着……跑团!?

大约半年前,我曾经跑过一个DND(龙与地下城)3R版本的新手团,用了几天时间读完了玩家手册,又用两个晚上做好了角色卡,然而游戏体验却不佳,跑了一次就坑了。最让我不爽的是团内一个老玩家一直要修改我的角色卡(我是一个人类女性法师,增加了很多魅力),说『让专业的人做专业的事』『法师要有输出』云云,后来我也按要求修改了角色属性,但整场游戏却因角色的大改而让我感到索然无味,当初创造角色的热情也荡然无存。
转眼半年过去,除了一些常规桌游,我还玩了万智牌这种深坑游戏,虽然也挺有趣,但总归比较
『一夜情』——两个玩家遵循同样的规则即可游戏,全程不需要社交,仅仅是竞技。适逢《 Pathfinder 开拓者核心规则书》众筹,我突然想起当初想要跑团的激情,于是买了一套《 Pathfinder 开拓者基础包》先体验一下,然后再看是否也支持一下核心规则。
(下图来自乐博睿官方)
DSC6230_meitu_1
基础包可以当做 Pathfinder 的一个体验版,用非常实惠的价格,提供了跑团必备的组件,通过基础包可以比较完整的理解『什么是跑团』。
1.pi
2.pi

基础包的内容包含:

  • 一套跑团用的骰子(共6枚)
  • 一包用来支撑人物和怪物指示物的底座
  • 简化版玩家手册
  • 简化版城主手册
  • 预设角色卡4份(已经做好的法师/战士/游荡者/牧师)
  • 空白角色卡4张
  • 双面可擦写地图1张
  • 指示物纸板(共4张,其中怪物指示物有2张,这是中文版福利)

预设角色卡4份(已经做好的法师/战士/游荡者/牧师)

4.pi
这四份预设角色卡已经完整录入了角色数据,可以拿来直接玩,对于不懂做卡、或懒得做卡的新人来说,非常友好。反观 DND 团,在推新中并无这样的便利方式(也因为 DND 没有中文官方支持),新人还不知道跑团的乐趣所在就被要求拿着一把300页的玩家手册自学创造角色,这是非常不友好、也不利于推广的。

指示物纸板(共4张,其中怪物指示物有2张,这是中文版福利)

 
5.pic
据说英文版基础包只有3张指示物纸板,中文版则多送了一张怪物指示物,且指示物纸板厚实、质量颇高,很有诚意(其实整个基础包都是诚意满满)。有这玩意,其实我真心觉得模型不必要了,因为未涂装或低质量的模型也并不敏感增加代入感,还不如硬纸片。

双面可擦写地图1张

6.pi
很大一张,正面是地城地图,背面是自定义地形地图,均可擦写。

简化版的玩家手册和城主手册

7.pi
两本书都仅有几十页,很快就可以看完。再次对比 DND 陡峭的学习曲线……(其实 DND 也有简化版的玩家手册,忘了是否是官方出品,但大多数玩家还是要求你先看完整版)

骰子和指示物底座

8.pi
指示物底座不多说了。骰子质量很一般,但是足够用。对于新人体验 Pathfinder 来说,确实没必要附带一套定制的华丽骰子,尽量用最低成本体验游戏是最重要的。这一点我很赞同。

关于跑团众

在深圳,可以很容易找到跑团众,每周都有固定的团。其他一线城市也都比较容易找到队友。如果实在找不到,就只能网团了。

关于我自己

我还没跑过 Pathfinder,简化版玩家手册的开篇提供一个单人团,可以让玩家自己先模拟跑一跑,今晚我就会用预设角色卡跑一下试试。看到其他网友的跑团日志说带着老婆孩子一起玩 TRPG,非常羡慕那种其乐融融的感觉。毕竟在完了不少单人桌游后,我愈发感觉到,一个人的游戏简直不能称之为游戏(仅仅是杀时间而已)。

Tagged : / / / /

[翻译]雷霆之石进阶版:单人变体规则

pic1196537_md

【最近买了《雷霆之石进阶版》,发现官方的单人规则太变态,几乎无法玩下去,于是上网查看玩家自创的规则。例如 Epic Thunderstone 就是玩家们创造的非常棒的一个玩法(已经被官方收录到进阶版说明书中)。今天我翻译的这个,是对雷霆之石进阶版单人规则的改进版。喜欢 solo 的朋友可以尝试一下。原文链接

这篇变体规则是 雷霆之石/雷霆之石进阶版 单人规则的修改版。首先声明,我是按照 Tom Vasel 的『史诗模式:雷霆之石』规则玩的(链接)。唯一的区别是,我在牌堆中放入了10-15张随机洗牌过的卡牌、而不是把所有卡牌都放进去。这样操作使得摧毁牌堆中的卡牌更有效率。这个变体规则也可以与 雷霆之石 常规单人游戏规则混用。之所以做出这个变体规则,是因为我一点都不喜欢游戏规则书中的单人变体规则——怪物们每回合向村庄不停前进,你根本没有时间构筑自己的牌库去击退它们保卫村庄。在我的变体规则中,你获得了构筑牌库的时间(这正是游戏的乐趣所在!),然后每隔一段时间与怪物们交战。

游戏背景:

村庄笼罩在被地牢怪物入侵的危险之中。幸运的是,一个保护咒语将怪物们封印在地牢中、阻止它们逃出来攻击乡村。然而,封印每隔七天就会弱化,怪物们将在这第七天逃出地牢、入侵村庄。你和你的探险队被招募来保卫村庄,每隔七天就需要进入地牢、消灭怪物。

步骤

  1. 按你的偏好设置 雷霆之石/雷霆之石进阶版。注意此时地牢大厅是空的。
  2. 需要一个用来计算天数的骰子。将骰子设置为『6』,标志着你到达村庄的第一天。
  3. 和普通游戏时一样,第一回合访问村庄。回合结束时重新抓手牌,并将骰子调整到『5』。此时一只怪物从地牢牌堆中前进一级,来到地牢大厅的最深处。
  4. 从这一回合开始,你可以按照对你最有利的策略,来选择『探索地牢』『访问村庄』『休养生息』和『整装待发』。
  5. 每回合结束时抓取新的手牌,将骰子调低1个点,然后将地牢大厅中的所有怪物前进一级,空出来的位置由怪物牌堆中新翻出来的怪物填满。
  6. 骰子上的每个数字代表着日期倒计时(『6』是第1天,『5』是第2天,『4』是第3天,『3』是第4天,『2』是第5天,『1』是第6天)。下面是第7天的内容:
  7. 如上所述,当骰子调整到『1』时,你处于第6天。在你抓完新手牌、此回合结束时,将骰子调整到『6』。这标志着第7天的到来,保护咒语开始失效,地牢大厅中的所有怪物倾巢出动、攻向村庄(如果你上个回合刚刚攻击过地牢,那么这回合将少一个怪物。你需要利用刚刚抓取的新手牌来对付所有的怪物)。
  8. 按顺序与每个怪物交战。因为怪物们已经离开地牢进入开阔地,所有怪物不再拥有漆黑度惩罚。
  9. 与第一个怪物交战。如果有任何英雄、武器、物品在战斗中被摧毁,那么在后面的战斗中将无法使用。在杀死所有从地牢大厅中跑出来的怪物、或者每个逃脱的怪物摧毁一张村庄中的卡牌之前,不能抓取新手牌。你和每个怪物按常规规则单独交战,唯一的区别是战斗后不抓取新手牌,你要用这些固定的卡牌来迎战所有怪物。
  10. 成功消灭怪物后,你会从每个被击败的怪物身上获取 XP,然后抓取新手牌,开始循环新的 7 天。由于刚刚的战斗发生在第 7 天,所以你将骰子维持在『6』,再用刚抓的手牌开始新的回合,继续另一个 7 天循环(见第 3 步)。
  11. 如果有些怪物你无法击败,那么每个未被击败的怪物将入侵村庄并摧毁任意一个牌堆顶部的卡牌。你自己来决定具体摧毁哪张卡(我通常用骰子来决定,『6』摧毁一个英雄,『5』摧毁一个武器,『4』摧毁一个村民,『3』摧毁一个咒语,『2』摧毁一件物品,『1』由我自己选择摧毁一张牌。所有逃脱的怪物攻击村庄后,我把骰子调到『6』开始新的 7 天循环)。
  12. 像常规单人游戏规则一样,所有攻击村庄的怪物都放到一起,将它们的 VP 加总,与你获得的 VP 进行比较。
  13. 『战利品』与『后果』在每次战斗后单独结算。任何允许你从村庄购买或获取一张卡的特殊能力,都可以在每次战斗中触发。
  14. 当所有怪物都被击败或逃脱到村庄时,游戏结束。如果你的 VP 大于入侵村庄的怪物 VP 总值,那么你成功保卫了村庄。如果怪物的 VP 大于你的 VP,那么你因未能拯救村庄而失败。

我真的很喜欢这样玩单人版 雷霆之石。 之所以设定在第 7 天与大量怪物交战,是为了提高游戏的挑战性。我曾把规则设置为只有一个怪物逃脱,但这样你就会知道怪物来袭的时间,然后『整装待发』。整场游戏如果只有 1 到 2 只怪物逃脱,赢得胜利就太过简单。如果每隔 7 天地牢大厅的所有怪物一起逃出地牢,你或许可以击败最前面的一两只,但最终会耗尽力量、无法阻止剩余的怪物攻击村庄。这样有助于维持游戏的平衡性。同时 7 天循环也给你足够的时间构筑牌库,而不至于疲于奔命、丧失游戏的乐趣。

Tagged : /

又开始学习新玩意:双拼输入法

多年来,我的个人兴趣呈发散状,遍布互联网的各个小众圈子。从电脑硬件到刀具弹弓、从桌游万智牌到开源硬件、从写代码到拆解机械表、从音响到尤克里里爵士鼓……兴趣爱好太多会带来一些问题,例如习惯了浅层学习、对深度学习有障碍,几乎所有爱好的领域都不算什么专家,都是票友水平。然而真的停不下来……
今天就新增加了一个小小的兴趣——双拼。
早就听说双拼能提高打字效率,一直没兴趣学,今天看了篇文章说学习时间很短,对输入速度提高很大,就用了一下午学习了一下。目前大概使用了两个小时,基本键位差不多记住了,打字速度还比较缓慢,但可以初步感受到双拼效率较全拼更高的原因了。
双拼的原理很简单,就是汉语拼音,其编码规则是把三个双声母 zh、ch、sh 和 35 个韵母安排到键盘的 26 个字母键位上,将所有汉字简化为『1个声母+1个韵母』,这样任何一个汉字都可以用最多2个按键来,而不必像全拼一样必须输入每个汉字的拼音的全部字符。双拼的缺点是,由于键位并不对应键盘字符,所以需要记忆键位(有点像五笔),那种『几个小时的学习让你秒杀全拼』的说法是不现实的。
双拼有多种布局,使用最广的自然码布局如下图。
自然码
举个例子,全拼输入『民主自由』的按键顺序是『min zhu zi you』,而在双拼中则是『mn vu zi yb』,从11次按键降低到8次;全拼输入『共产党』是『gong chan dang』,双拼则是『gs ij dh』,按键次数从12次降低到6次,输入效率竟提高了一倍。在我磕磕绊绊使用双拼的这两三个小时中,自己的输入速度已经在逐渐提高(虽然还不能达到最熟练的全拼的速度),相信随着练习时间的延长,会提高的越来越快。
可惜认识的人中没听说有人使用双拼输入法,否则可以交流下学习心得了。
(大半个月没更新博客,是自己懒惰了,最近代码也没写几行,非常内疚。)

完成《Flask Web Development》纪念

DSC_0129-01_meitu_1
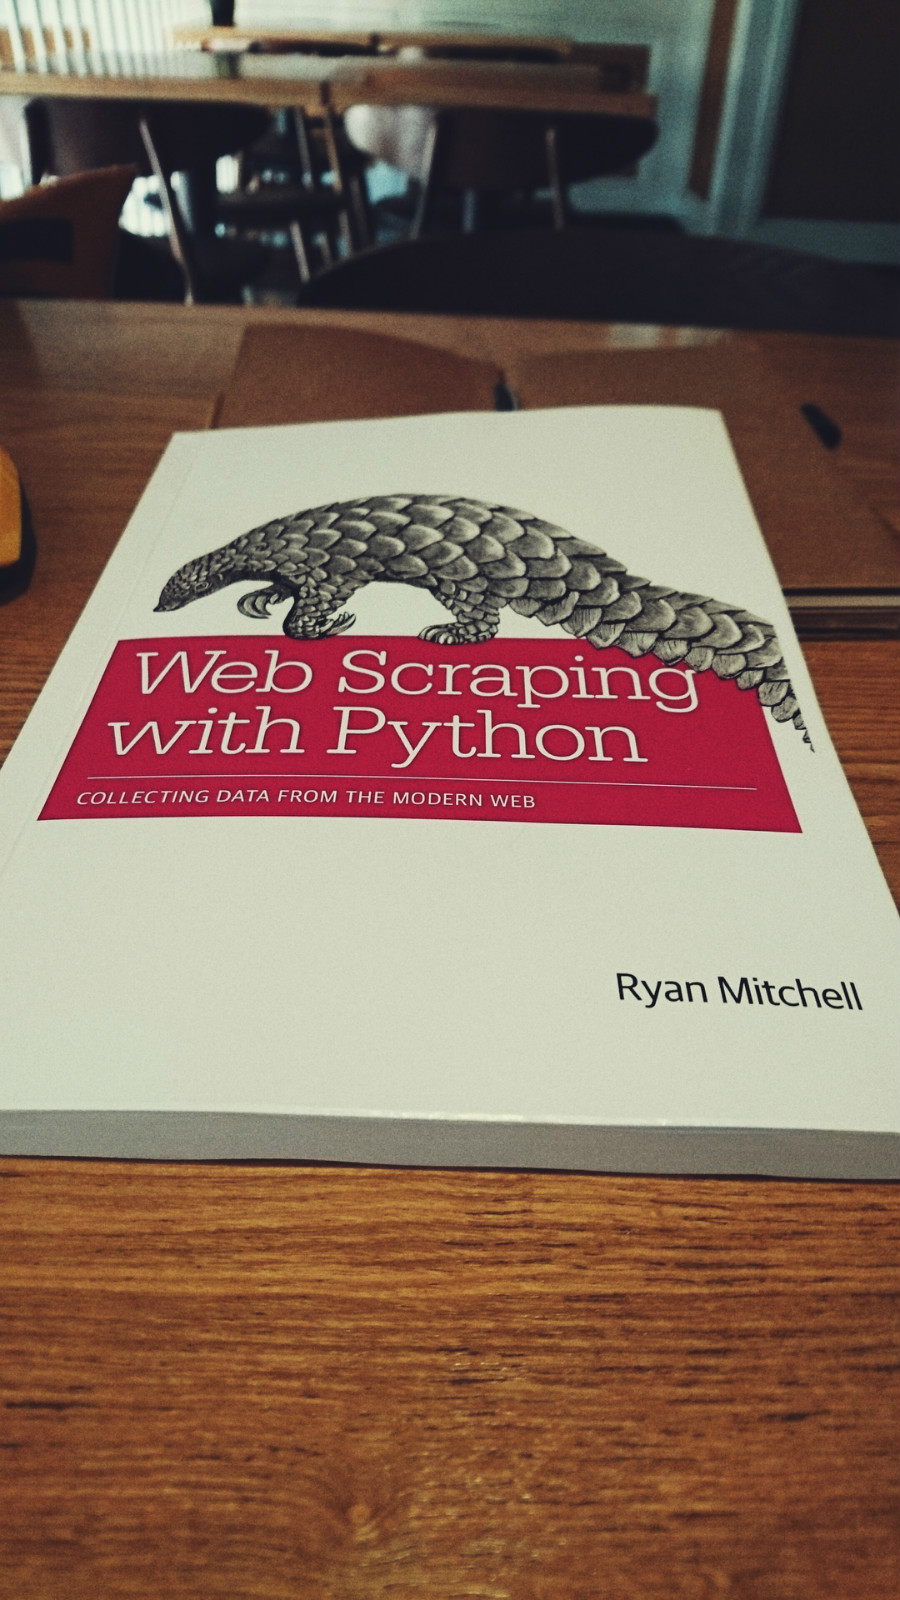
(上图为计划中的下一本书《Web Scraping with Python》)
这本 Flask 教材抱着啃了一个月,终于搞定了。标题里之所以说是『完成』而不是『学完』,是因为实际上我确实只是完成——所有的代码都手打了一遍。但是到底学没学会,对自己持悲观态度。这本书内容比较集中,但是细节很多,我又是第一次接触 web 框架甚至是第一次接触 web 开发,读完全书、打完全部代码,实际上也只是盲人摸象的对 web 开发有了大致印象,远远不能算『学会』。(Ps.本书中有若干小错,例如代码文件的路径等等,但是辨识后不影响学习。官方提供的代码有一些教材内的功能没有完成。)
不过我对这种感觉也并不陌生。在完成《笨方法学 Python》的时候,也有类似的体验,书中内容都学了,但合上书后并不知道自己能实现什么,深深的『啥都不会做』感,只是后面接触了更多的 Python 知识后,这种不安才慢慢消散。有了那一次的经验以后,我就不再担心这种『无力感』。相信这种感觉在短时间内可能还会重现多次,但并不代表我真的『啥都不会做』。
回顾一下从去年11月开始至今的学习,自己的速度并不快。学习过的书有:

除了笨方法以外,其余都是英文。所以读这些技术书,对自己的英文阅读也有一些帮助。从《Automate》一书开始,我习惯将原书 PDF 下载后通过淘宝打印。并且多亏了朱老师的全程指导,才能在转行程序员的道路上坚持走下去。
目前写过的一些小工具:

  • 桌游《阿瓦隆》——基本使用 python 语法把规则写了一遍,当时完全不知道数据库,也不懂部署。
  • 基金净值统计——用爬虫抓取自己的基金现价,然后计算目前自己的持仓市值
  • 给基友用 pandas 做的数据处理脚本——这个代码最少,但是我最喜欢,因为解决了原本很麻烦的实际问题。
  • 其他的都是一些跟着教程做出来的东西。

在 Python 的各个用途中,最让我感到神奇的是爬虫和数据处理,也是我曾经实现过的两个脚本的功能。爬虫可以自己阅读、解析、抓取、统计网络上的各种数据、甚至可以跨过 JS 像真实用户一样去操作页面;而 pandas/numpy 这些工具居然可以以远超过我想象的速度处理惊人的数据。我希望自己能够在这两方面加深一下学习。
后面我为自己规划的学习路径是这样的:
1、完成实验楼的 Flask 轻博客项目(已完成)
2、开发一个自己的网站(还没想好需求)
3、完成《Web Scraping with Python》
将这三个任务完成,目测应该已经起码到达八月中旬了。届时找一份 junior developer 的工作应该问题不大。如果在工作之余仍有时间学习,会继续在爬虫和数据处理方面钻研,然后看看自己更喜欢哪方面。

Tagged : / / /

用 python + pandas 帮朋友处理数据

郭老师发小的老公,在一家 Apple 手机电池供应商工作。这天在朋友圈抱怨,用 Excel 处理几十万条数据,i7 处理器 5 分钟进度 1% 。我一下反应过来,这玩意用 Python 处理起来应该很快啊!
于是留言给他说,用excel跑最起码几个小时,让他把文件和处理要求发给我。
过了一会,邮箱收到。其实比较简单,文件 A 有40万条电池数据,文件 B 有30万条良品电池数据,要用 A 减掉 B,剩下来的就是不良电池的数据。数据处理的目标即得到汇总了不良电池数据的文件 C 。
这里有个小插曲:文件 A 有40多万行数据,我用 Mac 的 Number 打开,仅能显示 65535 条。看来 Numbers 处理稍大一点的数据就完全不行了。为了能顺利检视数据结果,又下载了 OpenOffice。
虽然之前没接触过 Python 的数据处理,但是学习过用 Python 的 openpyxl 处理 Excel 表格,所以我的第一反应就是用 xlrd 这种第三方库来处理 Excel 无法快速处理的文件。但是在学习 xlrd 的过程中,发现 xlrd 可以比较好的读取文件,却不能很好的写入文件,于是 又下载了对 Excel 写入支持较好的 xlwt 。
折腾了半天,虽然实现读写,但是对表格的处理还是不满意。随便搜一搜,发现 pandas 也可以做这个工作。于是转向 pandas 。
pandas 支持读取/写入 XLSX 和 CSV 格式,由于我用的是 Mac ,因此将文件先统一转换成了 CSV 。
首先用 pandas 读取 CSV 文件并转化为 DataFrame:

df = pd.read_csv(workbook, low_memory = False)

然后将文件 B 复制到文件 A 需要去重的列下方(这里可以用代码操作,但是我没有查操作函数,因为感觉手动复制粘贴也很方便)。再用 drop_duplicates 函数去掉重复的项(这里需要注意,drop_duplicates 有好几个参数,可以选择留下重复项中的第一项、最后一项、或者全删掉,视需求而定)。

new_df = df.drop_duplicates(subset = '要去重的列名称,必须英文', keep = False)

最后用 to_csv 函数保存成新的 CSV 文件即可。脚本一共 5 行代码,运算处理时间只有几秒钟。
为了减少朋友以后的工作量,我把脚本写好发给他,并将『文件名』等可自定义的部分留空了。有兴趣请点 这里 看我写的脚本。
这个 5 行代码脚本我大约写了三个小时,主要时间都在学习。在帮了朋友的忙时,也实现了我 Python 学习史的好几个第一次:
第一次现学现卖,当天下午就用陌生的知识完成任务。
第一次帮朋友解决了实际问题。
第一次完成了一件数据处理工作。
非常开心,非常值得纪念!

Tagged : / /

Poker 键位调整

DSC_0100_meitu_1
因为昨天上午刚刚收到 Poker 键盘,因此没来得及进行键位调整。昨天用了一下午加一晚上,感觉还有些地方比较别扭:

  • 『~』的输入较麻烦。不过昨天已经微调解决了,将键盘后面的2号开关打开,将『·~』换到右下角的Ctrl。
  • 代码过程中,经常会需要用上下左右的方位键,然后Poker将四个方位精简到了WSAD上,每次进行调整光标位置,都需要 Fn + WSAD,而 Fn 在键盘的右下方,所以需要两个手才能调整,比较麻烦。
  • 由于 Poker 使用了标准 Windows 键位,因此 Win 键与空格键之间有一个 Alt,这与 Mac 的键位不太一样,我想将 Win 键作为 Cmd 键使用,并将 Win 与 Alt 切换位置。

第一个问题比较容易解决,但是第二个问题有点麻烦,我尝试用 Poker 进行键位编程,想将左侧的 CapLock 键换成 Fn,但是搞了半天没成功,看说明书才发现 Fn 和 Pn 是不能进行编程的。看来只能通过软件修改键位映射。
小小研究了一下,发现也不用第三方的工具,仅依靠 Poker 的背后开关加上 Mac 自带的键盘修饰键功能即可实现 Cap 与 Fn 的交换。具体方法如下:

  1. 将开关 1 和 3 都拨到 ON 的位置,使 Caps 变成 Fn,左 Win 变成 Caps,右 Fn不变
  2. 打开 Mac 的系统偏好设置 – 键盘 – 修饰键,选择 Poker
  3. 更改修饰键:
    Caps Lock -> Option
    Control -> Control
    Option -> Command
    Command -> Option
  4. 最后用拔键器,将 win 和 alt 两个按键切换位置,就可以完美实现 Mac 的键位布局。

另外有个小技巧,如果需要连续大量使用方向键,一直 Cap + WSAD 也不是一个好方法。此时可以 Fn + 空格,将 WSAD 切换为方向键,然后再 Fn + 空格 又可以切换回来。
总的来说,小键盘的使用肯定不如大键盘方便,毕竟 60% 的空间却承载了 100% 的功能。但是通过一些定制,可以在一定程度上缓解小键盘局促的面积带来的琐碎操作。为了随时随地能够使用机械键盘,这点牺牲是值得的,只是需要几天的适应时间。另外可能还有更好的键位方案,期待未来能将小键盘改造的非常贴合自己的需求。

Tagged : /

新键盘测评:Poker升级版白色红轴,爽爽哒

上回说到,旧键盘因为苹果的安全策略升级而无法在Mac上正常使用,我急需一个新键盘来替补。于是昨天下单,今天上午送货上门,389元入手iKBC在2016年4月11日新发布的Poker新品——Poker升级版。
1
Poker升级版其实是以Poker2为蓝本,修正了Poker2的USB口松动等小问题,同时将升级了芯片(我觉得没个鸟用,反正只有一层编程层)。在C87/C104发布之后,Poker系列的更新是出乎意料的,相当于iKBC将全部产品线都进行了升级。原来的Poker/Poker2已经从官网删除,Poker系列仅剩Poker(即升级版)和Poker3。
我入手的是红轴版本,包装盒上用扑克牌表示轴的类型,红桃即红轴。
2
开箱后内容比较精简,键盘纸箱+线缆+赠送的6枚 RGB 键帽+一个拔键器+说明书。
3
白色键盘若隐若现,看得我非常动心。
4
6枚 RGB 键帽非常美貌,在各式开箱文中已经见识过了,白色键盘配上饱满鲜艳的亮色,绝对是无法抗拒的漂亮,我估计果粉们都会喜欢这样的配色吧。
6
虽然已经有了心理准备,且我上一把键盘是80%的小键盘,但刚把 Poker 掏出来的时候仍能被其小体积震到。下图是键盘全貌,非常小巧。我与 Victorinox 的猎人军刀(91mm)做对比,可知这键盘尺寸有多袖珍。
5
一些测评提到,Poker升级版的超低价格牺牲了做工,导致键帽边缘有毛刺。我看了一下,确实有一些毛刺,但是恐怕对 99% 的用户来说都是无所谓的,因为如果不仔细查找,你是完全不会注意到这些细节的。所以针对 399 元的价位,这个键盘绝对是超值的。
7
背部的四个开关是调整键位用的,其中 4 号开关是对编程层写保护,我因为并不需要进行编程,因此到手就打开了写保护。另外因为在命令行中会经常使用『~』,所以打开了 2 号开关、将左上角的『`~』调整为右下的 Control 键(如果不打开这个,输入『~』会很极麻烦—— Shift + Fn + Esc……)。
8
下图为左 Shift 的卫星轴。区别于 Noppoo Choc Mini84的平衡杆,Poker 的大键全部使用卫星轴。手感上,平衡杆更加干脆,也更加松动;而卫星轴略显肉,却有更好的反馈力度。说实话,如果选择青轴键盘,可能还是平衡杆更加爽快,但红轴则搭配更加温柔的卫星轴比较好。
9
测试了一下手感之后,我马上更换上了 RGB 键帽。据郭老师反馈,加了彩色键帽之后,Poker 的美貌可爱异常出众。顺便一提,Poker 已经为改灯留好了空间、无需飞线(从 Poker2 开始就这样)。但是我个人对灯毫无感觉,跑马灯容易把键盘整体搞的奇 Low 无比,浓浓的杀马特气息。
11
在 Mac 上折腾了一下,完美适配,多媒体按键也无压力。简单看了一下别人对键盘的编程方案,似乎对我没什么用,于是不再更改映射,可以直接上手用了。Poker 还支持固件升级,现在还没搞懂咋弄,这两天研究一下。
12
午饭后,把写字的家伙们带到咖啡馆,开始一下午的工作。顺便再推荐一下我这几个月的工作场地——『格啡咖啡 Gaffe Pro』,我一直呆在二楼,偶尔生意好会比较人多,但大多数时候还是很适合一个人默默的写代码的。下图中的设备:2013年的 Macbook Pro,富勒 X100 游戏鼠标,比目鱼笔记本支架,卡西欧 GWM-5610 电波表,iKBC Poker 升级版樱桃红轴机械键盘。
13
目前在我的几个小时的 Poker 使用时间过程中,还没有产生任何不好的体验。以我目前的上手经验,这款键盘非常值得买,如果代码或写字较多,可以考虑像我一样买红轴,打字舒坦,手指放松,同时可以搭配一块木头腕托(我已下订单,在路上),据说对提升手感有奇效。
另外切记——在公共场合(咖啡馆/办公室)请勿使用青轴键盘。不要问我怎么知道的。

Tagged : / /